La mayoría de las conversaciones sobre LLM self-hosted empiezan por las GPU: qué tarjeta, cuánta VRAM, qué servidor de inferencia. Pero hay toda una clase de tareas para las que una GPU es excesiva: clasificar tickets de soporte, extraer unos pocos campos de un texto, enrutar peticiones, generar respuestas cortas en una herramienta interna. Para ellas puede bastar un modelo pequeño en un servidor con CPU corriente, que cuesta lo mismo que el VPS más barato.
Para comprobar cómo funciona en la práctica, construimos un servicio mínimo: local-inference-x86-05b. Ejecuta Qwen2.5-0.5B-Instruct sobre PyTorch sin GPU, expone una API de chat con FastAPI y se distribuye como una única imagen Docker linux/amd64 que funciona totalmente offline. En este artículo repasamos las decisiones de diseño, mostramos cifras reales de un servidor de pruebas y enumeramos con honestidad lo que todavía no está listo para producción.
Por qué un modelo de 0,5B en una CPU
Qwen2.5-0.5B-Instruct tiene unos 0,5 mil millones de parámetros, admite un contexto largo y se publica bajo la licencia Apache 2.0, así que se puede usar comercialmente. Es dos órdenes de magnitud más pequeño que los modelos detrás de ChatGPT o Claude, y se nota: un modelo de este tamaño sabe poco del mundo y razona con dificultad. Lo que sí hace razonablemente bien es seguir instrucciones sencillas sobre el texto que le das.
Un despliegue en CPU tiene sentido cuando:
- Los datos no pueden salir de tu perímetro. Datos personales, contratos, tickets internos: un modelo local elimina la cuestión de transferir datos a un proveedor externo (consulta nuestro artículo sobre LLM y RGPD).
- El entorno es offline o aislado. Redes de fábrica, instalaciones on-premise en el cliente, segmentos air-gapped.
- La carga es baja y predecible. Decenas o cientos de peticiones por hora, no miles por minuto.
- Necesitas un sustituto barato de una API de LLM para desarrollo, pruebas o demos.
Si necesitas un alto rendimiento o modelos más grandes, mira servidores con GPU como vLLM; comparamos las opciones en la guía sobre LLM self-hosted.
La arquitectura en una imagen
El proyecto es pequeño a propósito: dos archivos de Python, un Dockerfile y un workflow de CI.
local-inference-x86-05b/
├── app/
│   ├── model.py      # carga del modelo, generate() y stream()
│   └── main.py       # FastAPI: GET /health, POST /chat
├── Dockerfile        # multi-stage: deps → model → runtime
├── pyproject.toml    # dependencias, índice de PyTorch solo CPU
└── .github/workflows/docker.yml   # build y publicación en GHCR
El recorrido de una petición es sencillo: FastAPI valida el JSON, la chat template del modelo convierte la lista de mensajes en un prompt, transformers genera tokens en la CPU y la respuesta se devuelve como un único objeto JSON o como un flujo de Server-Sent Events.
Imagen Docker: offline, compacta y sin root
El Dockerfile tiene tres etapas y cada una resuelve un problema concreto.
1. PyTorch solo para CPU. El paquete por defecto de PyTorch en Linux arrastra librerías CUDA que pesan gigabytes. Un servidor con CPU no las necesita, así que pyproject.toml apunta uv al índice específico para CPU:
[tool.uv.sources]
torch = [{ index = "pytorch-cpu" }]

[[tool.uv.index]]
name = "pytorch-cpu"
url = "https://download.pytorch.org/whl/cpu"
explicit = true
Las dependencias se instalan con uv sync --frozen desde el lock file, con un cache mount de BuildKit, de modo que las reconstrucciones tras cambiar el código tardan segundos.
2. Pesos incluidos en la imagen. Una etapa aparte descarga el modelo de Hugging Face durante el build y conserva solo los archivos necesarios para la inferencia:
FROM deps AS model
ARG MODEL_ID=Qwen/Qwen2.5-0.5B-Instruct
RUN /opt/venv/bin/python -c "from huggingface_hub import snapshot_download; \
snapshot_download('${MODEL_ID}', local_dir='/models/model', \
allow_patterns=['*.json', '*.safetensors', '*.txt', '*.model', 'merges.txt'])"
La etapa de runtime define HF_HUB_OFFLINE=1 y TRANSFORMERS_OFFLINE=1. El contenedor nunca sale a internet: arranca en una red cerrada, no depende de la disponibilidad de Hugging Face y el tag de la imagen fija una versión exacta de los pesos. Eso hace los despliegues reproducibles: el mismo tag significa el mismo modelo. El argumento de build MODEL_ID permite incluir otro modelo sin tocar el código, por ejemplo Qwen/Qwen2.5-Coder-0.5B-Instruct.
3. Runtime mínimo. La imagen final contiene solo python:3.12-slim, el entorno virtual, los pesos y el código de la aplicación. El proceso se ejecuta con un usuario sin privilegios app, y el HEALTHCHECK consulta /health con un periodo de arranque de 60 segundos, suficiente para que el modelo se cargue en memoria.
API: un formato de chat conocido
El servicio expone dos endpoints. GET /health devuelve el estado y el modelo en uso. POST /chat acepta una lista de mensajes en el formato que todos conocen de las API de OpenAI y Anthropic:
{
  "messages": [
    {"role": "system", "content": "You are a helpful assistant."},
    {"role": "user", "content": "hello what are you the model?"}
  ],
  "max_new_tokens": 256,
  "temperature": 0.7
}
Pydantic valida la petición: al menos un mensaje, roles limitados a system, user y assistant, max_new_tokens de 1 a 2048 y temperature de 0 a 2. Con temperature: 0 se pasa a decodificación greedy, útil para extracción y clasificación, donde quieres un resultado determinista. Swagger UI está disponible en /docs.
Esta es la misma petición enviada al servicio desplegado en nuestro servidor de pruebas:
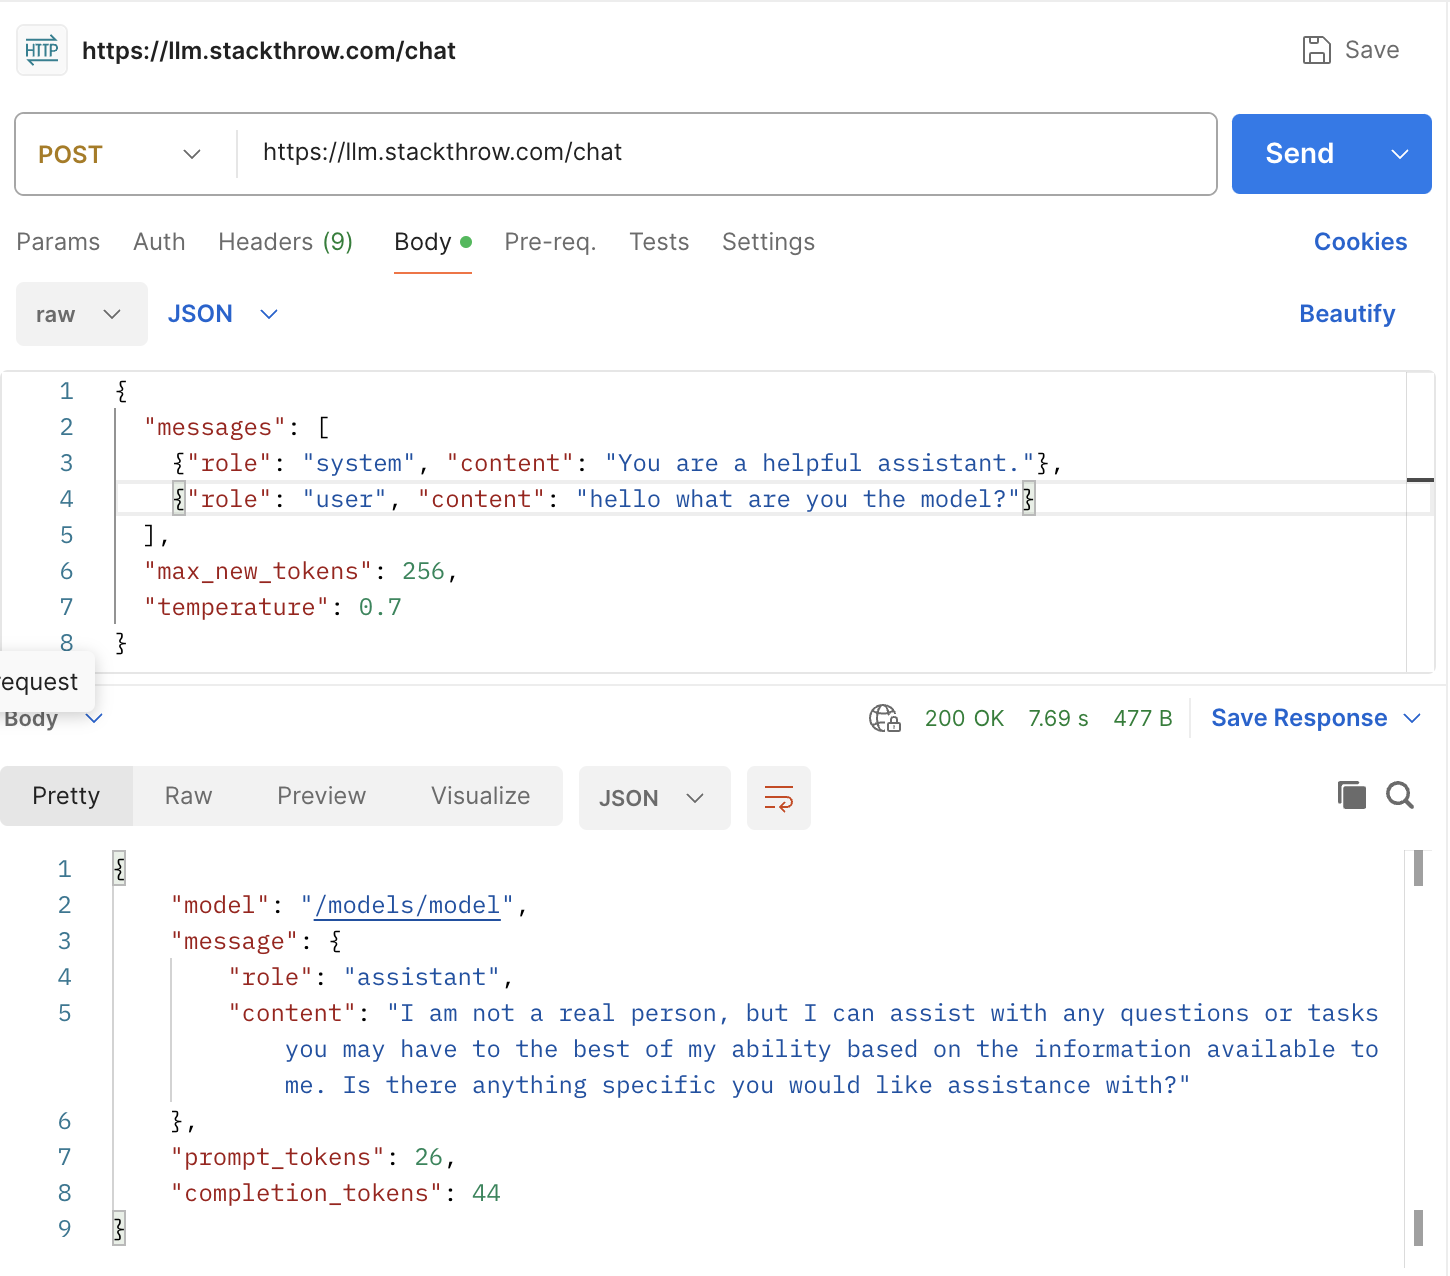
Hay dos cosas que conviene observar. La primera es la velocidad: 44 tokens en 7,69 segundos, incluida la red, son aproximadamente 5–6 tokens por segundo de extremo a extremo en un servidor virtual modesto. Es suficiente para tareas en segundo plano y respuestas cortas, pero una respuesta de 500 tokens tardaría más de un minuto, así que para interfaces interactivas necesitas streaming. La segunda es la calidad: ante la pregunta "¿qué modelo eres?", el modelo respondió con generalidades y no dijo su nombre. Es lo típico en un modelo de 0,5B. Si la identidad o el tono importan, escríbelos explícitamente en el system prompt y no confíes en el conocimiento propio del modelo sobre hechos.
La respuesta incluye además prompt_tokens y completion_tokens, algo práctico para el logging y la planificación de capacidad, aunque los tokens no cuesten nada.
Streaming con SSE
Con "stream": true el servicio devuelve text/event-stream: fragmentos del tipo data: {"content": "..."} y un data: [DONE] final:
curl -N localhost:8000/chat -H 'content-type: application/json' -d '{
  "messages": [{"role": "user", "content": "Escribe un haiku sobre Docker"}],
  "stream": true
}'
Por dentro, la generación se ejecuta en un hilo aparte y TextIteratorStreamer de transformers entrega el texto decodificado al generador de FastAPI a medida que aparece:
def stream(self, messages, max_new_tokens, temperature, top_p):
    kwargs = self._prepare(messages, max_new_tokens, temperature, top_p)
    streamer = TextIteratorStreamer(self.tokenizer, skip_prompt=True, skip_special_tokens=True)

    def run() -> None:
        with self._lock, torch.inference_mode():
            self.model.generate(**kwargs, streamer=streamer)

    thread = threading.Thread(target=run, daemon=True)
    thread.start()
    for chunk in streamer:
        if chunk:
            yield chunk
    thread.join()
El usuario ve las primeras palabras en una fracción de segundo en lugar de esperar la respuesta completa. Cómo consumir este flujo en el frontend lo explicamos en el artículo sobre chat con IA en Next.js con streaming.
Concurrencia: una generación cada vez, a propósito
La línea más importante de model.py es fácil de pasar por alto:
# CPU generation is compute-bound; running requests in parallel only slows each of them down.
self._lock = threading.Lock()
En una GPU, los servidores de inferencia agrupan peticiones en lotes y atienden decenas en paralelo. En una CPU, una sola generación ya ocupa los núcleos disponibles con multiplicaciones de matrices. Dos generaciones en paralelo compiten por los mismos núcleos y el mismo ancho de banda de memoria: cada una va aproximadamente al doble de lento y el tiempo total no mejora. Por eso el servicio procesa las peticiones estrictamente una tras otra, y las demás esperan al lock.
El resto del código está pensado para que esa espera no bloquee el servidor: la petición normal se ejecuta con run_in_threadpool y el generador de streaming es síncrono, así que FastAPI también lo itera en un pool de hilos. /health sigue respondiendo durante una generación larga, de modo que el orquestador no reinicia un contenedor que simplemente está ocupado.
Dos detalles más específicos de CPU:
- El modelo se carga en
float32. Los pesos en Hugging Face están en bf16, pero muchos procesadores x86 no tienen aritmética bf16 rápida, y float32 es la opción segura por defecto. El precio es la memoria, como veremos. - La variable
TORCH_NUM_THREADSlimita el número de hilos. Es útil si el contenedor comparte servidor con otros servicios o si el límite de CPU del cgroup es menor que el número de núcleos que ve PyTorch.
Lo que ve el servidor
Este es el panel de monitorización del servidor de pruebas donde corre el contenedor:
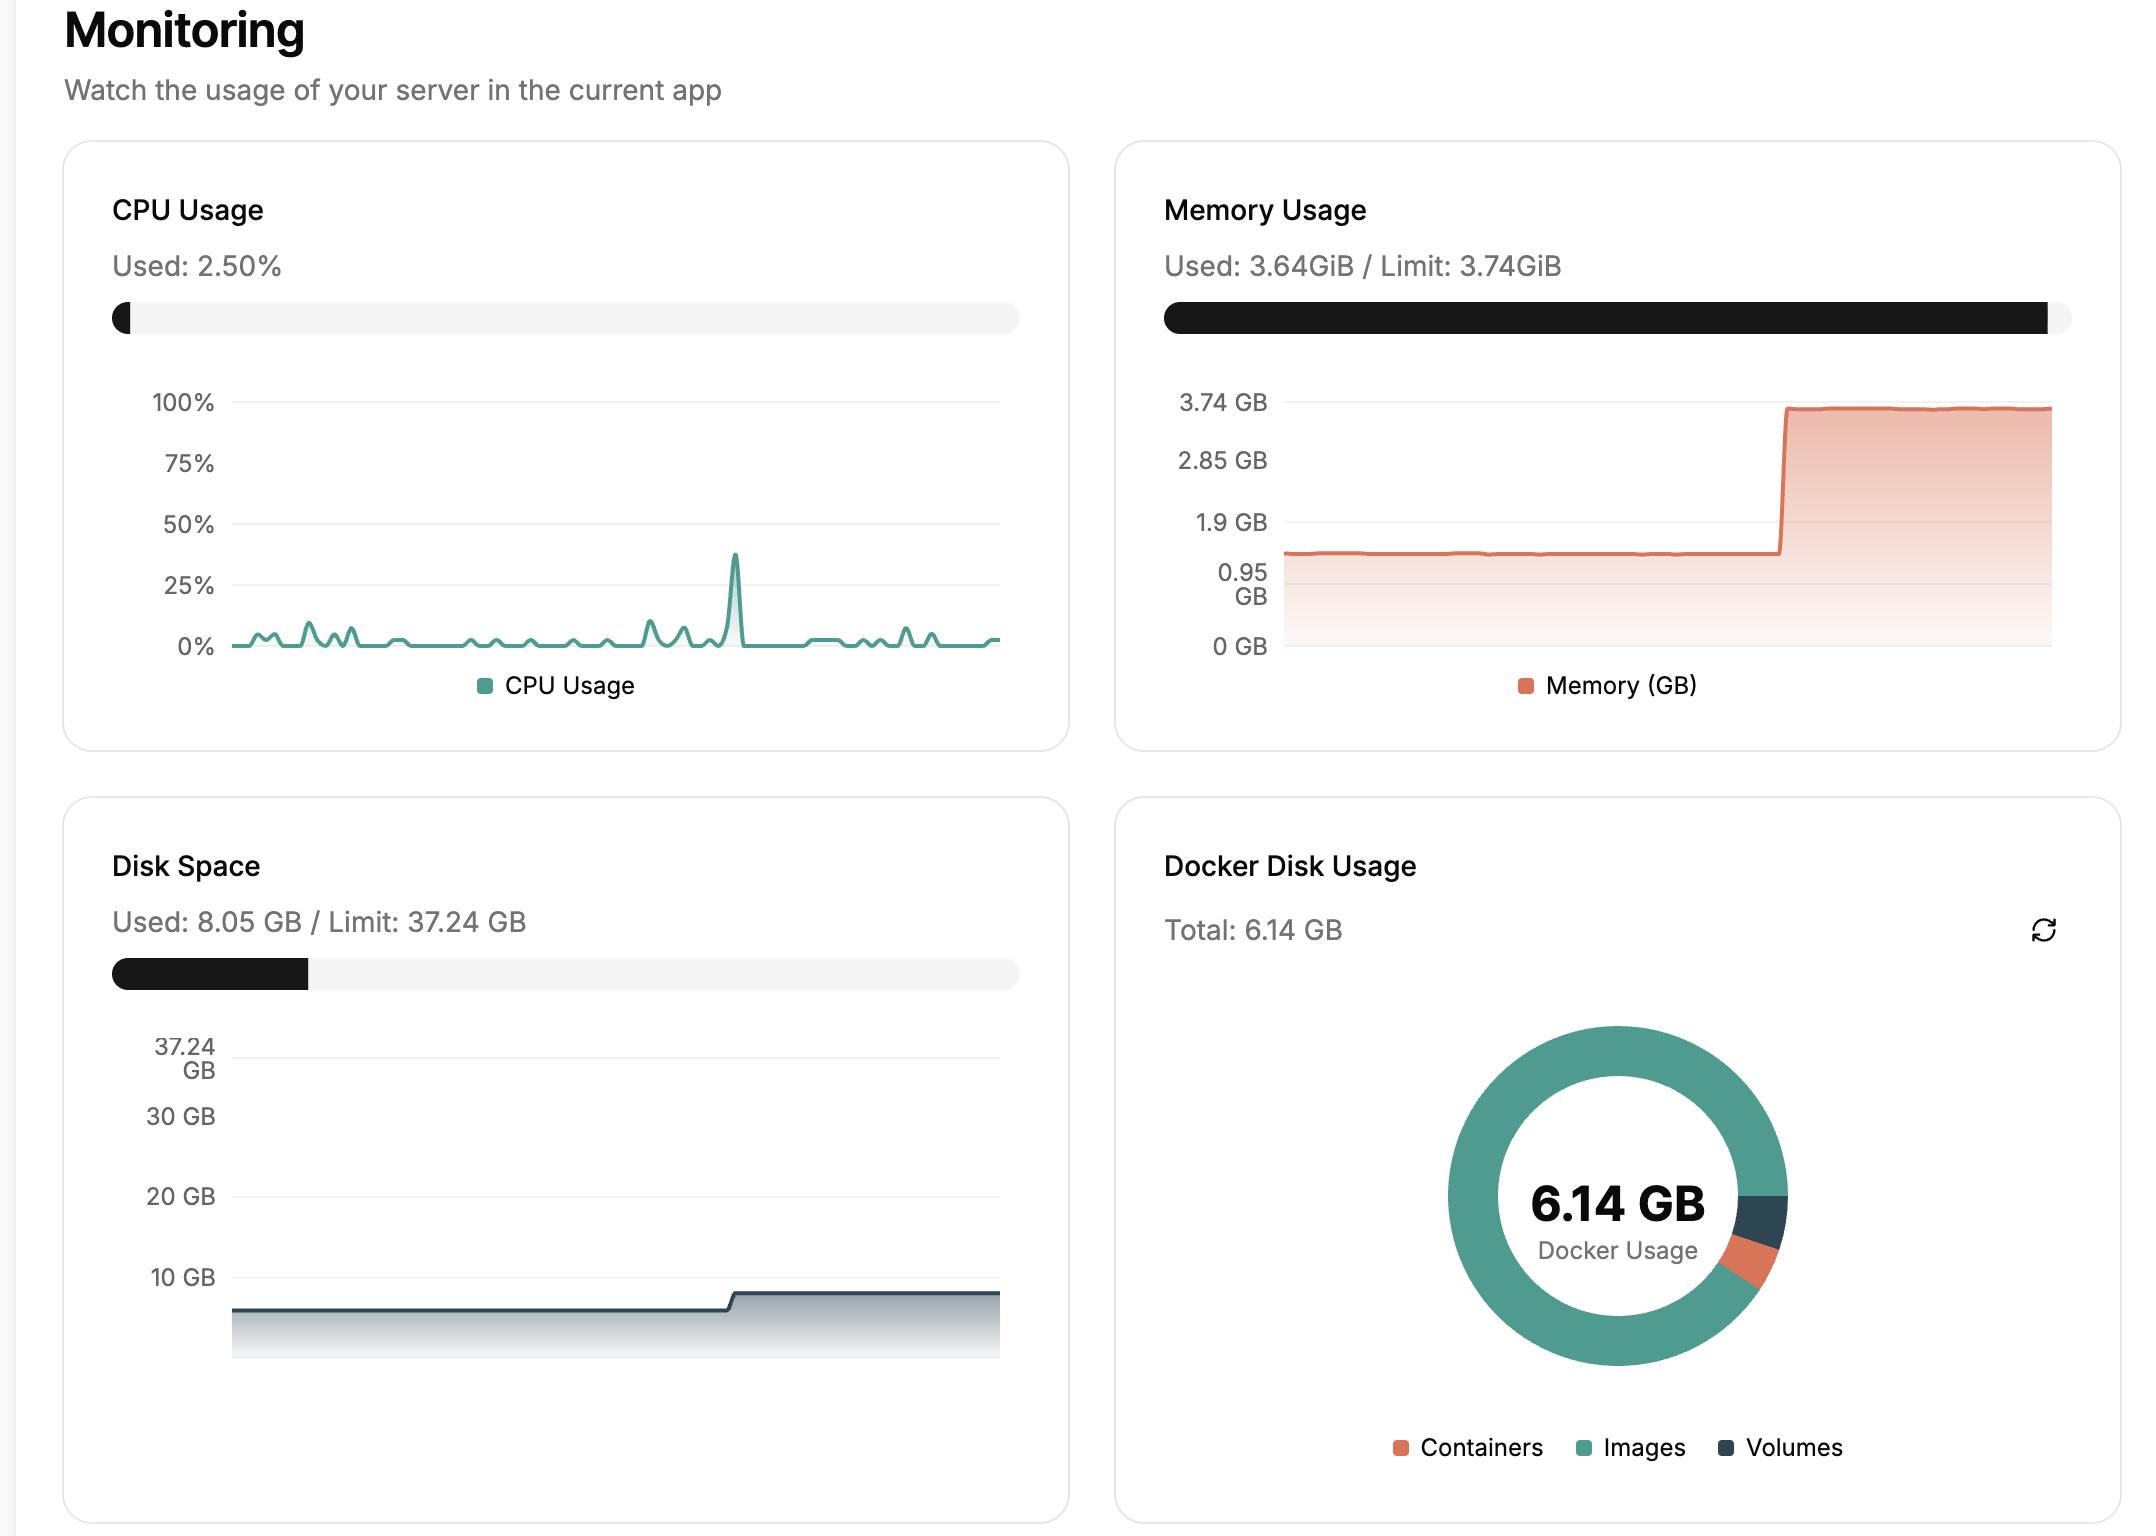
Lo que nos dice:
- La CPU está ociosa entre peticiones. Un 2,5% en reposo y picos breves durante la generación. El panel promedia por intervalo de muestreo, así que unos segundos a plena carga parecen un pico estrecho. El patrón es el correcto: el procesador solo trabaja mientras genera.
- La memoria es el cuello de botella. El gráfico refleja todo el servidor. Tras arrancar el contenedor, el uso subió unos 2,5 GB y se mantiene en 3,64 de 3,74 GiB. Cuadra con la aritmética: 0,5 mil millones de parámetros × 4 bytes en float32 son unos 2 GB de pesos, más PyTorch, el tokenizador y los buffers. En un servidor de 4 GB apenas queda margen, y el siguiente servicio puede acabar víctima del OOM killer.
- El disco no es un problema. Docker ocupa 6,14 GB, sobre todo imágenes. PyTorch solo para CPU y un conjunto compacto de pesos mantienen el tamaño bajo control.
Conclusión práctica: para este modelo, reserva al menos 4 GB de RAM para el contenedor, define un límite explícito con --memory y, si necesitas ahorrar memoria, considera bf16 en procesadores que lo soporten (AVX-512 BF16, AMX) o modelos GGUF cuantizados con llama.cpp, donde un modelo de 0,5B ocupa unos cientos de megabytes.
Build y publicación en CI
El workflow de GitHub Actions construye la imagen en cada push y pull request. En los push a main/master y en los tags v*, publica la imagen en GitHub Container Registry con tags de rama, semver, SHA del commit y latest. El build usa la caché de GitHub Actions mediante cache-from/cache-to: type=gha, así que las capas pesadas con PyTorch y los pesos no se reconstruyen cada vez.
Arrancarlo es un solo comando:
docker run --rm -p 8000:8000 --memory 4g \
  ghcr.io/stackthrower/local-inference-x86-05b:latest
O sin Docker, para desarrollo local:
uv sync
uv run uvicorn app.main:app --port 8000
Lo que falta para producción
El proyecto es una base funcional, no un producto terminado. Antes de abrirlo a usuarios reales, añadiríamos:
- Autenticación. La API está abierta. Como mínimo, una API key en una cabecera o un reverse proxy con autenticación delante.
- Límite de cola y timeouts. Las peticiones esperan al lock indefinidamente. Bajo carga es mejor devolver
429o503de inmediato que acumular una cola de peticiones cuyos clientes ya se han desconectado. - Cancelación cuando el cliente se desconecta. Si un cliente de streaming se cae, el hilo de generación sigue hasta
max_new_tokensy retiene el lock. Comprobarrequest.is_disconnected()y detener la generación conStoppingCriterialo resuelve. - Métricas. Tiempo de generación, tokens por segundo, longitud de la cola. Sin ellas es imposible saber cuándo toca escalar. Más detalles en nuestro artículo sobre observabilidad de LLM.
- Evaluación de la calidad en tu tarea. Antes de confiar en un modelo de 0,5B, pruébalo con un conjunto de ejemplos reales de tu dominio. Nuestra guía de evals para LLM explica cómo hacerlo.
- Un nombre de modelo legible en la respuesta. El campo
modeldevuelve ahora la ruta de archivos/models/model; es mejor devolver el ID original del modelo.
Cuándo elegir este enfoque
Un modelo pequeño en CPU encaja bien cuando la tarea es acotada, los datos son sensibles, la carga es baja y el presupuesto es limitado. Para tareas estructuradas, combínalo con formatos de salida estrictos y validación, como describimos en el artículo sobre salidas estructuradas. Si la calidad no alcanza, el siguiente paso no tiene por qué ser una GPU: prueba primero un modelo algo mayor (1,5B–3B) en formato cuantizado, que sigue funcionando en un procesador.
El código es abierto: github.com/StackThrower/local-inference-x86-05b. Si estás decidiendo entre ejecutar modelos en tu propia infraestructura o usar una API, o necesitas ayuda para llevar un servicio así a producción, escríbenos.