Більшість розмов про self-hosted LLM починається з GPU: яка відеокарта, скільки VRAM, який сервер інференсу. Але є цілий клас задач, для яких GPU — надмірність: класифікація звернень у підтримку, витягування кількох полів із тексту, маршрутизація запитів, короткі відповіді у внутрішньому інструменті. Для них може вистачити малої моделі на звичайному CPU-сервері, який коштує як найдешевший VPS.
Щоб перевірити, як це працює на практиці, ми зробили мінімальний сервіс: local-inference-x86-05b. Він запускає Qwen2.5-0.5B-Instruct на PyTorch без GPU, віддає чат-API через FastAPI й постачається як один Docker-образ linux/amd64, що працює повністю офлайн. У статті — архітектурні рішення, реальні цифри з тестового сервера й чесний список того, що ще не готове до продакшену.
Навіщо модель на 0,5B на процесорі
Qwen2.5-0.5B-Instruct має близько 0,5 млрд параметрів, підтримує довгий контекст і поширюється за ліцензією Apache 2.0, тож її можна використовувати комерційно. Це на два порядки менше, ніж моделі, що стоять за ChatGPT чи Claude, і це помітно: модель такого розміру мало знає про світ і слабко міркує. Зате вона непогано виконує прості інструкції над текстом, який ви їй даєте.
CPU-розгортання має сенс, коли:
- Дані не можуть залишати периметр. Персональні дані, договори, внутрішні тікети: локальна модель знімає питання передачі даних сторонньому провайдеру (див. нашу статтю про LLM і GDPR).
- Середовище офлайн або ізольоване. Заводські мережі, on-premise інсталяції в клієнта, air-gapped сегменти.
- Навантаження низьке й передбачуване. Десятки чи сотні запитів на годину, а не тисячі на хвилину.
- Потрібна дешева заміна LLM API для розробки, тестів чи демо.
Якщо потрібна висока пропускна здатність або більші моделі, дивіться в бік GPU-серверів на кшталт vLLM — ми порівнювали варіанти в гайді про self-hosting LLM.
Архітектура на одній картинці
Проєкт навмисно малий: два Python-файли, Dockerfile і CI-воркфлоу.
local-inference-x86-05b/
├── app/
│   ├── model.py      # завантаження моделі, generate() і stream()
│   └── main.py       # FastAPI: GET /health, POST /chat
├── Dockerfile        # multi-stage: deps → model → runtime
├── pyproject.toml    # залежності, CPU-only індекс PyTorch
└── .github/workflows/docker.yml   # збирання й публікація в GHCR
Шлях запиту простий: FastAPI валідує JSON, chat template моделі перетворює список повідомлень на промпт, transformers генерує токени на CPU, а відповідь повертається одним JSON-об'єктом або потоком Server-Sent Events.
Docker-образ: офлайн, компактний і без root
Dockerfile має три стадії, і кожна розв'язує конкретну проблему.
1. PyTorch лише для CPU. Стандартне колесо PyTorch для Linux тягне за собою бібліотеки CUDA на кілька гігабайтів. CPU-серверу вони не потрібні, тому pyproject.toml вказує uv на окремий CPU-індекс:
[tool.uv.sources]
torch = [{ index = "pytorch-cpu" }]

[[tool.uv.index]]
name = "pytorch-cpu"
url = "https://download.pytorch.org/whl/cpu"
explicit = true
Залежності ставляться через uv sync --frozen із lock-файлу з кеш-маунтом BuildKit, тож перезбирання після змін у коді займає секунди.
2. Ваги вшиті в образ. Окрема стадія завантажує модель із Hugging Face під час збирання й залишає лише файли, потрібні для інференсу:
FROM deps AS model
ARG MODEL_ID=Qwen/Qwen2.5-0.5B-Instruct
RUN /opt/venv/bin/python -c "from huggingface_hub import snapshot_download; \
snapshot_download('${MODEL_ID}', local_dir='/models/model', \
allow_patterns=['*.json', '*.safetensors', '*.txt', '*.model', 'merges.txt'])"
Runtime-стадія виставляє HF_HUB_OFFLINE=1 і TRANSFORMERS_OFFLINE=1. Контейнер ніколи не ходить в інтернет: він стартує в закритій мережі, не залежить від доступності Hugging Face, а тег образу фіксує точну версію ваг. Це робить деплої відтворюваними: той самий тег — та сама модель. Аргумент збирання MODEL_ID дозволяє вшити іншу модель без зміни коду, наприклад Qwen/Qwen2.5-Coder-0.5B-Instruct.
3. Мінімальний runtime. Фінальний образ містить лише python:3.12-slim, віртуальне середовище, ваги й код застосунку. Процес працює від непривілейованого користувача app, а HEALTHCHECK опитує /health зі стартовим періодом 60 секунд — цього вистачає, щоб модель завантажилася в пам'ять.
API: знайомий чат-формат
Сервіс має два ендпоінти. GET /health повертає статус і модель, що використовується. POST /chat приймає список повідомлень у форматі, який усі знають з API OpenAI та Anthropic:
{
  "messages": [
    {"role": "system", "content": "You are a helpful assistant."},
    {"role": "user", "content": "hello what are you the model?"}
  ],
  "max_new_tokens": 256,
  "temperature": 0.7
}
Pydantic валідує запит: щонайменше одне повідомлення, ролі лише system, user і assistant, max_new_tokens від 1 до 2048, temperature від 0 до 2. temperature: 0 перемикає на жадібне декодування — корисно для витягування даних і класифікації, де потрібен детермінований результат. Swagger UI доступний на /docs.
Ось той самий запит до сервісу, розгорнутого на нашому тестовому сервері:
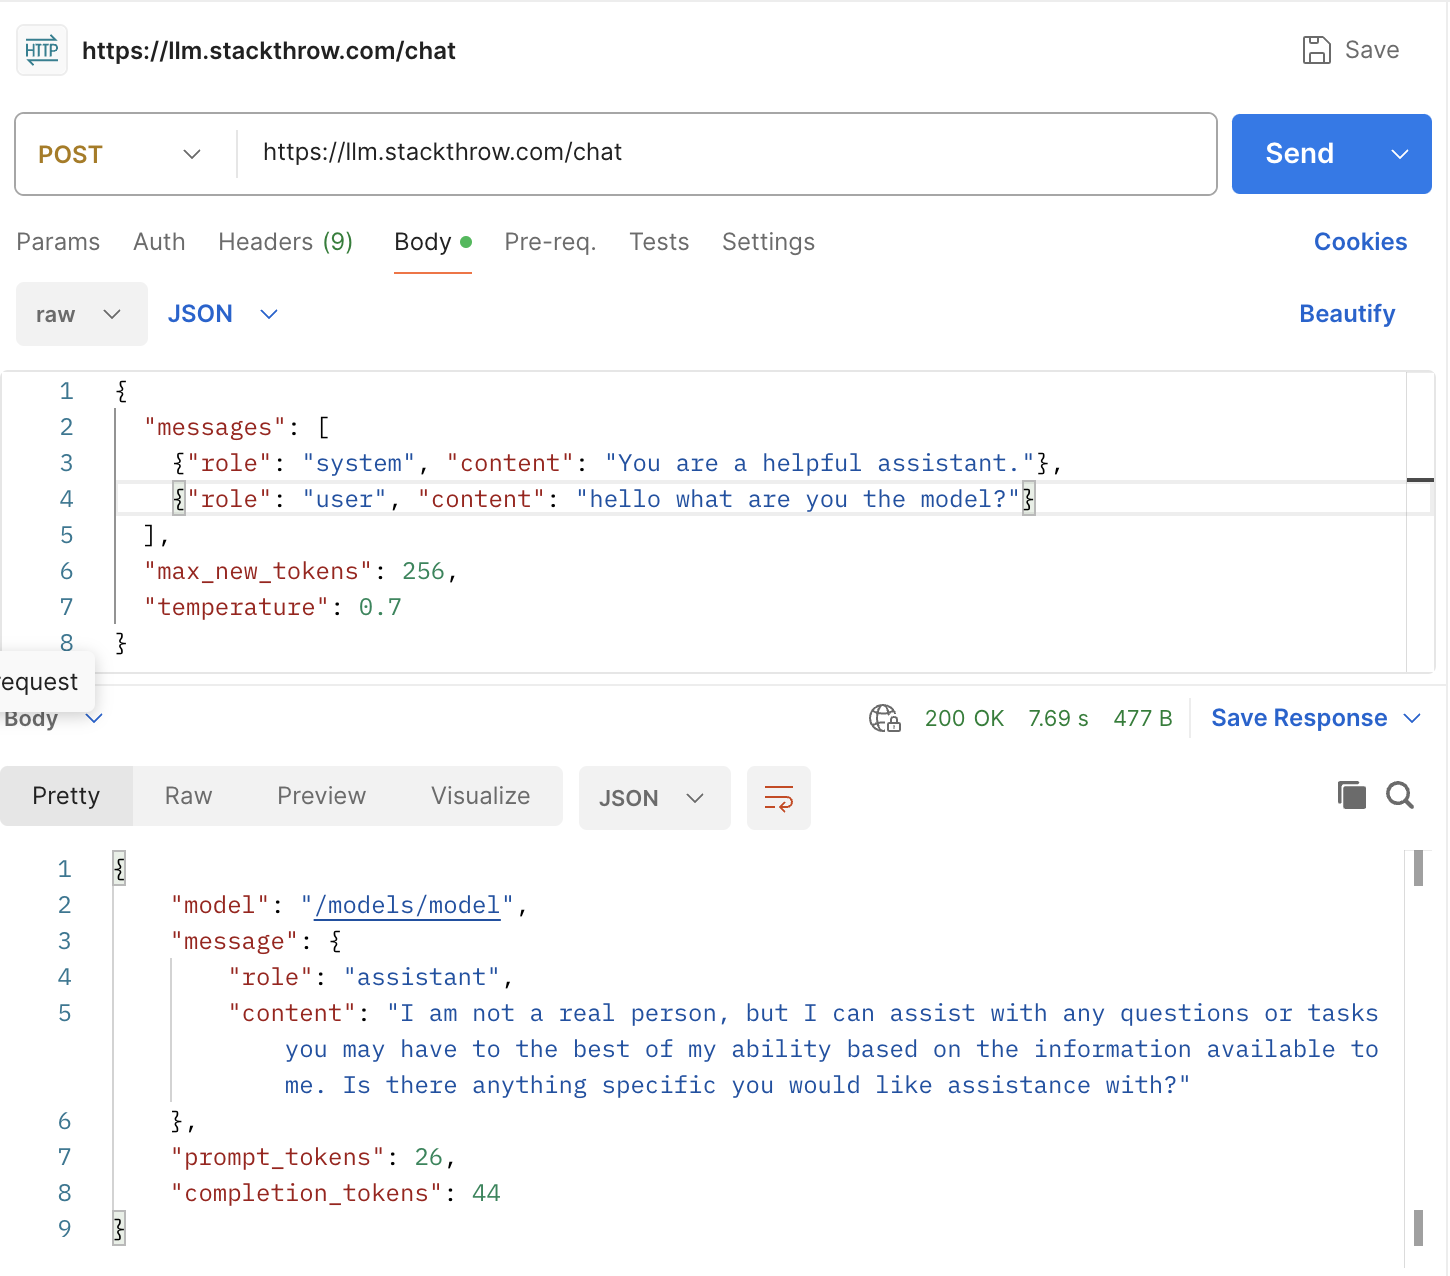
Тут варто звернути увагу на дві речі. Перша — швидкість: 44 токени за 7,69 секунди разом із мережею — це приблизно 5–6 токенів на секунду наскрізь на скромному віртуальному сервері. Для фонових задач і коротких відповідей цього достатньо, але відповідь на 500 токенів генеруватиметься понад хвилину, тож для інтерактивних інтерфейсів потрібен стримінг. Друга — якість: на запитання «яка ти модель?» модель відповіла загальними словами й не назвала себе. Це типово для 0,5B. Якщо важливі ідентичність чи тон, пропишіть їх явно в системному промпті й не покладайтеся на власні знання моделі про факти.
Відповідь також містить prompt_tokens і completion_tokens — зручно для логування й планування потужностей, навіть коли токени нічого не коштують.
Стримінг через SSE
З "stream": true сервіс повертає text/event-stream: фрагменти виду data: {"content": "..."} і фінальний data: [DONE]:
curl -N localhost:8000/chat -H 'content-type: application/json' -d '{
  "messages": [{"role": "user", "content": "Напиши хайку про Docker"}],
  "stream": true
}'
Під капотом генерація працює в окремому потоці, а TextIteratorStreamer із transformers передає декодований текст у генератор FastAPI в міру появи:
def stream(self, messages, max_new_tokens, temperature, top_p):
    kwargs = self._prepare(messages, max_new_tokens, temperature, top_p)
    streamer = TextIteratorStreamer(self.tokenizer, skip_prompt=True, skip_special_tokens=True)

    def run() -> None:
        with self._lock, torch.inference_mode():
            self.model.generate(**kwargs, streamer=streamer)

    thread = threading.Thread(target=run, daemon=True)
    thread.start()
    for chunk in streamer:
        if chunk:
            yield chunk
    thread.join()
Користувач бачить перші слова за частку секунди, а не чекає на всю відповідь. Як споживати такий потік на фронтенді, ми розбирали в статті про AI-чат на Next.js зі стримінгом.
Конкурентність: одна генерація за раз, і це свідомо
Найважливіший рядок у model.py легко пропустити:
# CPU generation is compute-bound; running requests in parallel only slows each of them down.
self._lock = threading.Lock()
На GPU сервери інференсу об'єднують запити в батчі й обслуговують десятки паралельно. На CPU одна генерація вже завантажує доступні ядра множенням матриць. Дві паралельні генерації конкурують за ті самі ядра й пропускну здатність пам'яті: кожна йде приблизно вдвічі повільніше, а загальний час не покращується. Тому сервіс виконує запити строго по черзі, а решта чекає на lock.
Решта коду побудована так, щоб очікування не блокувало сервер: звичайний запит виконується через run_in_threadpool, а стримінговий генератор — синхронний, і FastAPI теж ітерує його в пулі потоків. /health відповідає навіть під час довгої генерації, тож оркестратор не перезапускає контейнер, який просто зайнятий.
Ще дві деталі, специфічні для CPU:
- Модель завантажується у
float32. Ваги на Hugging Face зберігаються в bf16, але багато x86-процесорів не мають швидкої bf16-арифметики, тож float32 — безпечний варіант за замовчуванням. Ціна — пам'ять, що видно нижче. - Змінна
TORCH_NUM_THREADSобмежує кількість потоків. Це корисно, якщо контейнер ділить сервер з іншими сервісами або якщо ліміт CPU в cgroup менший за кількість ядер, яку бачить PyTorch.
Що бачить сервер
Ось дашборд моніторингу тестового сервера, на якому працює контейнер:
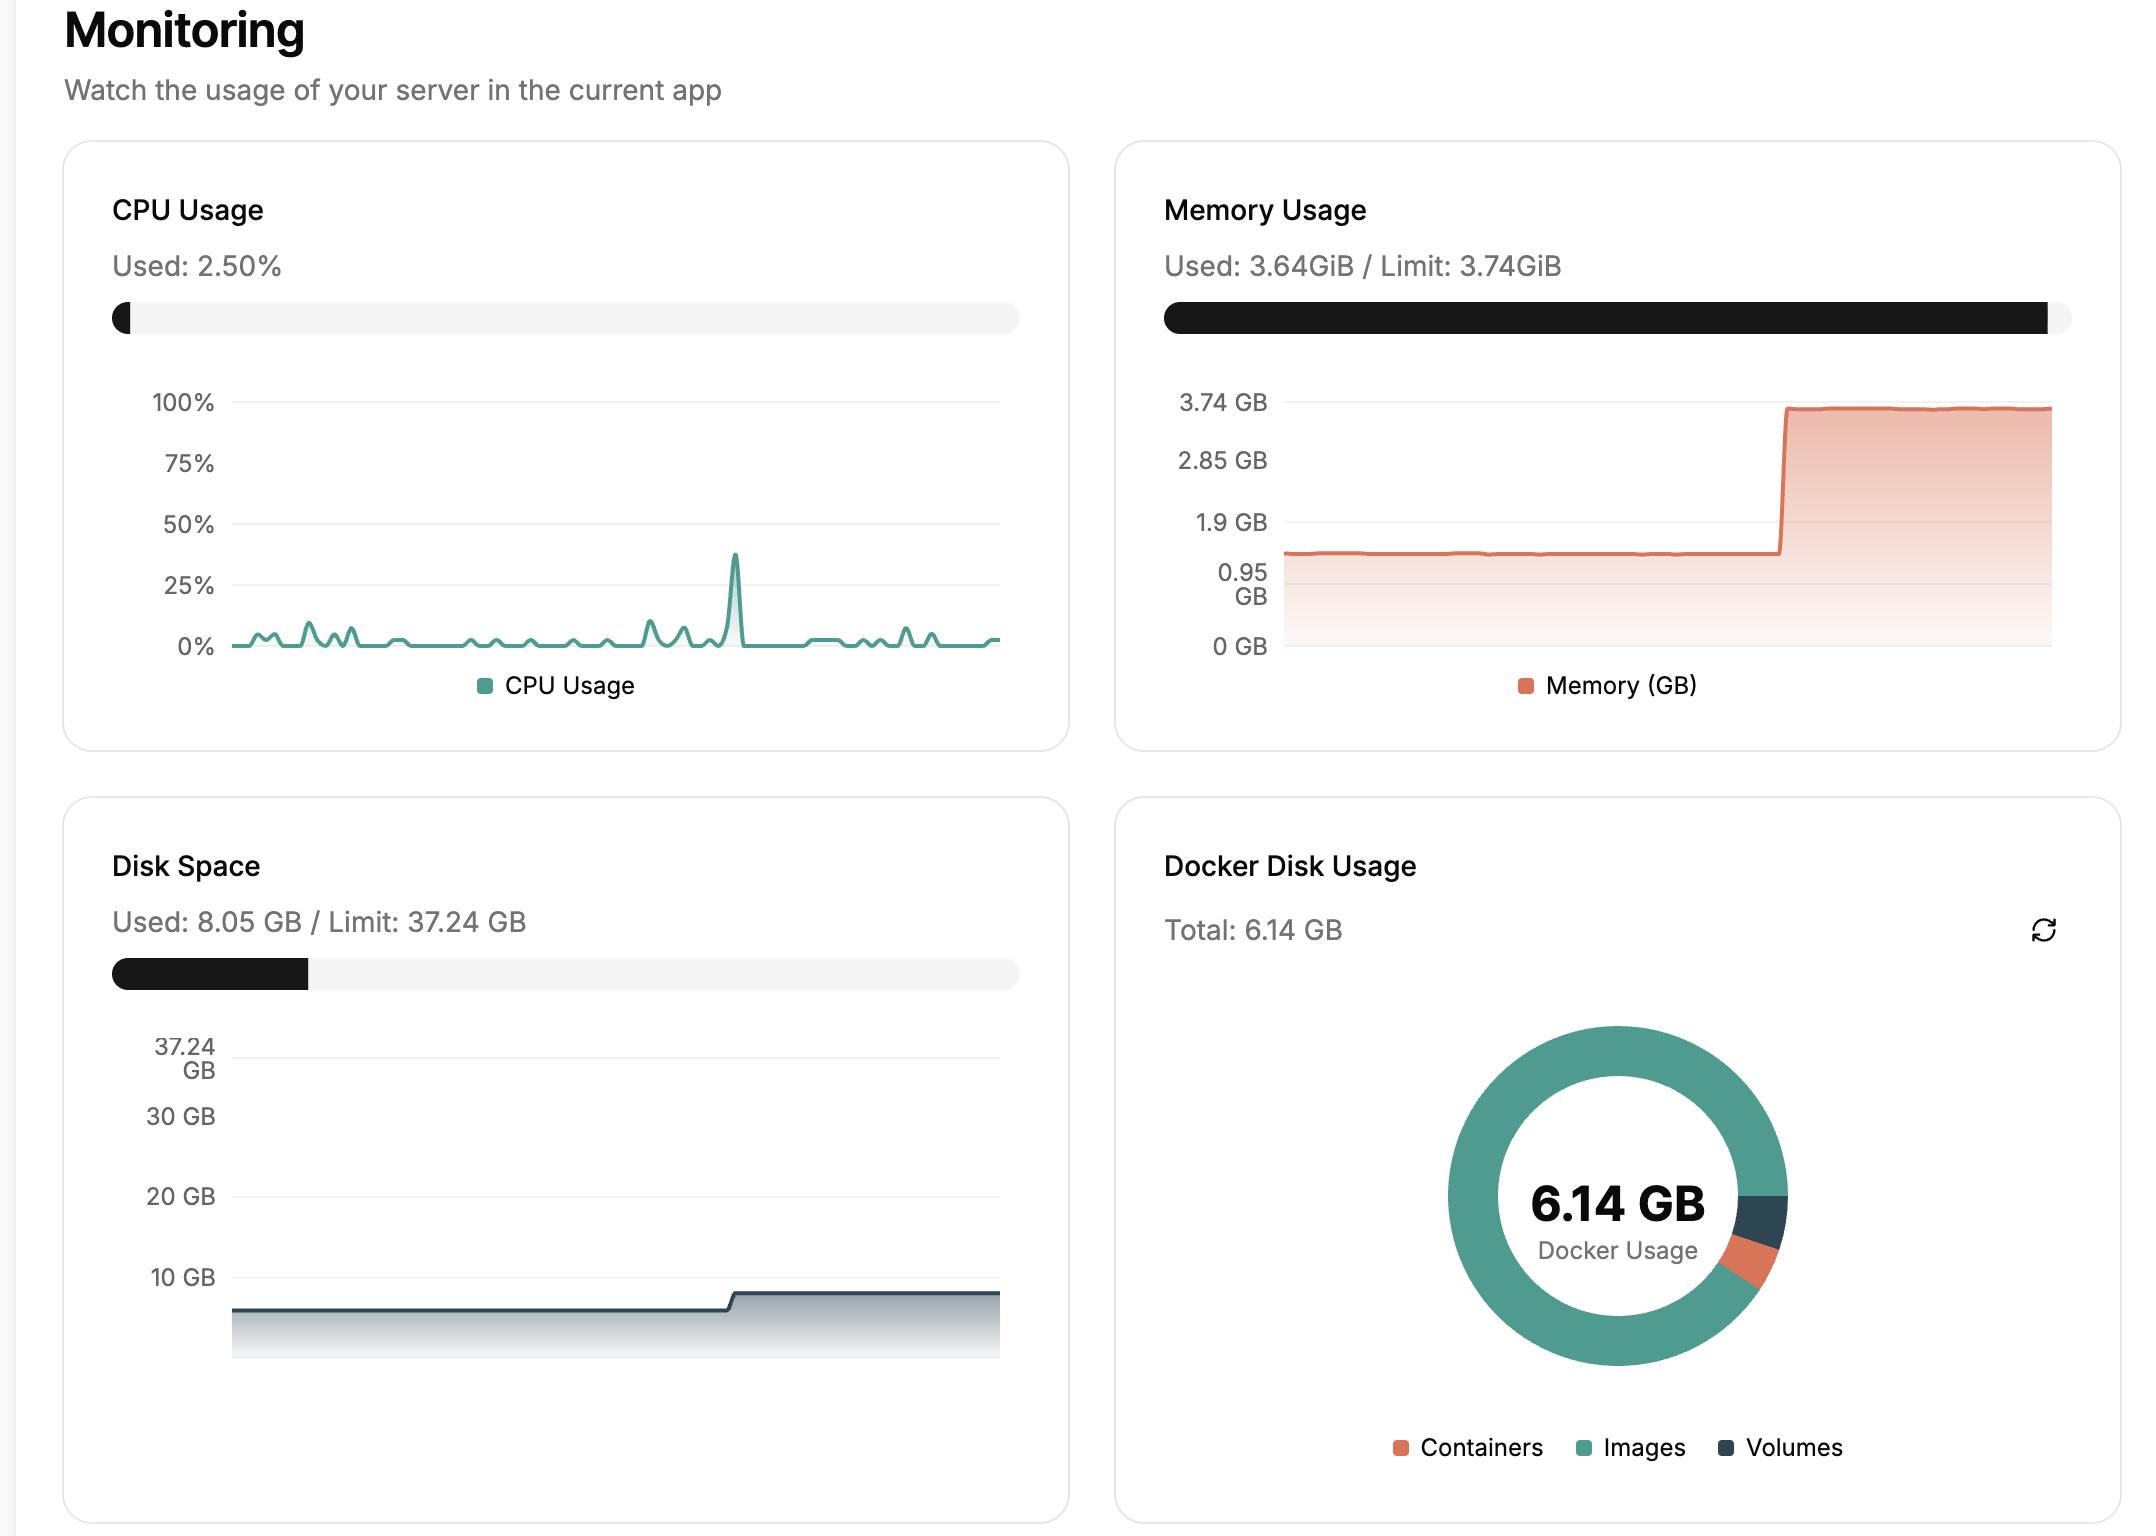
Що з нього видно:
- CPU простоює між запитами. 2,5% у спокої й короткі піки під час генерації. Дашборд усереднює значення за інтервал вибірки, тож кілька секунд повного навантаження виглядають як вузький пік. Сам патерн правильний: процесор працює лише під час генерації.
- Пам'ять — вузьке місце. Графік показує весь сервер. Після старту контейнера використання стрибнуло приблизно на 2,5 GB і тримається на 3,64 з 3,74 GiB. Це збігається з арифметикою: 0,5 млрд параметрів × 4 байти у float32 — близько 2 GB ваг, плюс PyTorch, токенізатор і буфери. На сервері з 4 GB запасу майже не лишається, і наступний сервіс може отримати OOM killer.
- Диск — не проблема. Docker займає 6,14 GB, переважно образи. CPU-only PyTorch і компактний набір ваг тримають розмір у межах.
Практичний висновок: для цієї моделі закладайте щонайменше 4 GB RAM під контейнер, задайте явний ліміт --memory, а якщо потрібно економити пам'ять — дивіться на bf16 на процесорах, які його підтримують (AVX-512 BF16, AMX), або на квантизовані GGUF-моделі з llama.cpp, де модель на 0,5B займає кілька сотень мегабайтів.
Збирання й публікація в CI
Воркфлоу GitHub Actions збирає образ на кожен push і pull request. На push у main/master і на теги v* він публікує образ у GitHub Container Registry з тегами гілки, semver, SHA коміту й latest. Збирання використовує кеш GitHub Actions через cache-from/cache-to: type=gha, тож важкі шари з PyTorch і вагами не перезбираються щоразу.
Запуск — одна команда:
docker run --rm -p 8000:8000 --memory 4g \
  ghcr.io/stackthrower/local-inference-x86-05b:latest
Або без Docker, для локальної розробки:
uv sync
uv run uvicorn app.main:app --port 8000
Чого бракує для продакшену
Проєкт — робоча основа, а не готовий продукт. Перш ніж відкривати його реальним користувачам, ми б додали:
- Автентифікацію. API відкритий. Мінімум — API-ключ у заголовку або reverse proxy з автентифікацією перед сервісом.
- Ліміт черги й таймаути. Запити чекають на lock необмежено довго. Під навантаженням краще одразу повернути
429або503, ніж накопичувати чергу запитів, клієнти яких уже відключилися. - Скасування при відключенні клієнта. Якщо стримінговий клієнт відвалився, потік генерації працює до
max_new_tokensі тримає lock. Перевіркаrequest.is_disconnected()і зупинка генерації черезStoppingCriteriaрозв'язують це. - Метрики. Час генерації, токени на секунду, довжина черги. Без них неможливо зрозуміти, коли час масштабуватися. Детальніше — у статті про observability для LLM.
- Оцінювання якості на вашій задачі. Перш ніж покладатися на модель 0,5B, проженіть її на наборі реальних прикладів зі своєї предметної області. Як це робити, описано в гайді з LLM evals.
- Зрозумілу назву моделі у відповіді. Поле
modelзараз повертає шлях до файлів/models/model; краще повертати оригінальний ID моделі.
Коли обирати цей підхід
Мала модель на CPU — гарний вибір, коли задача вузька, дані чутливі, навантаження низьке, а бюджет обмежений. Для структурованих задач поєднуйте її зі строгими форматами виводу й валідацією, як описано в статті про structured outputs. Якщо якості не вистачає, наступний крок — не обов'язково GPU: спершу спробуйте трохи більшу модель (1,5B–3B) у квантизованому форматі, яка все ще працює на процесорі.
Код відкритий: github.com/StackThrower/local-inference-x86-05b. Якщо ви вирішуєте, запускати моделі у себе чи користуватися API, або вам потрібна допомога з виведенням такого сервісу в продакшен, — напишіть нам.